
轻易云 CTO 5 大操作
CTO 的 5 大常用操作:从部署上线到知识库维护
摘要:作为 CTO,你不必像财务经理那样「一步一步操作对账」,也不必像 SRE 那样「凌晨 3 点盯监控」。但你必须能回答 5 个问题:① 怎么部署上线 ② 怎么看出系统健康度 ③ 性能基线是什么 ④ 安全防御有几道闸 ⑤ AI 知识怎么维护。本文把 5 件事拆成 5 大常用操作,每步配真实架构图与 B 级干货。
关键词:CTO、5 大操作、部署上线、监控运维、性能调优、安全管理、知识库维护、pnpm start:prod、JobTask、P95 基线、JWT × App-Key 双轨、双层沙箱、post-deploy-knowledge、RAG
第 0 分钟|为什么是「这 5 件事」
CTO 的日常工作里,「管技术」从来不是单一动作——你打开 IDE 的第一反应永远是 5 件事:
| 序号 | 动作 | 你在系统里做什么 | 决策时效 |
|---|---|---|---|
| ① | 部署上线 | pnpm start:prod 4 步流水线 + PM2 守护 + nginx 路径处理 | 每次发版 |
| ② | 监控运维 | NestJS Logger 命名空间 + KnowledgeQueryLog + JobTask 状态机 + Ops CLI | 实时 |
| ③ | 性能调优 | P95 基线(10/500/1200 行三档)+ v6 一维拍扁 + pgvector HNSW + D-V7 fire-and-forget | 压测 / 大促前 |
| ④ | 安全管理 | JWT × App-Key 双轨认证 + 双层沙箱 + API 网关限流 + 角色权限分层 | 持续 |
| ⑤ | 知识库维护 | post-deploy-knowledge 双通道灌装 + embedding fire-and-forget + 1536 维全零兜底 | 每次业务变更 |
新手 CTO 关心的 3 个问题先答掉:① 5 件事前 3 件可以让 SRE 代看,后 2 件(安全 + 知识库)必须自己定调;② 频率:部署每周 N 次 / 监控实时 / 性能季度复盘 / 安全月度审计 / 知识库随 PR 走;③ CTO 与 SRE 的差别是「SRE 守系统稳,CTO 守系统不漂」。
下面 5 步走完一遍,每步配真实架构图与踩坑提醒。
第 1 步|部署上线:4 步流水线 + 五层一致性
CTO 进系统的第一件事——怎么把代码安全地搬到线上。本仓库用一条命令搞定:pnpm start:prod。
1.1|4 步流水线的真实顺序
pnpm start:prod 不是一个命令,是三个独立步骤的串联。直接打开仓库根目录的 package.json:
"start:prod": "pnpm db:migrate && pnpm build && node scripts/start-prod.mjs"
链路是这样的:
| 步骤 | 实际命令 | 职责 | 耗时参考 |
|---|---|---|---|
| ① 数据库迁移 | pnpm --filter @recon/api prisma migrate deploy | 把 schema 变更应用到生产数据库 | 1-3 s(无新迁移时 < 1 s) |
| ② Prisma Client 生成 + 全包构建 | pnpm --filter @recon/api prisma generate && turbo run build | 同步 TypeScript 类型,再编译所有包与 app | 30-90 s(首次冷构建可达 2 分钟) |
| ③ 启动编排脚本 | node scripts/start-prod.mjs | 检查产物、清理旧进程、同步知识库、spawn API(4001) + Web(3001) | 8-15 s |
这三步是 && 串联——任一步非零退出,后面的步骤直接不跑。这条契约保证你不会带着一个构建失败的产物去启动服务,也不会带着未迁移的数据库去跑新代码。
为什么不能合成一个独立命令?因为这是 monorepo 工程。三个 app(@recon/api、@recon/web、PM2 守护层)和三个共享包之间有严格的依赖方向:共享包先编译,app 再编译;schema 变更要先于类型生成。任何一步错位,下游就会拿着过期类型继续运行。
下图是仓库的部署架构全景——客户端经 nginx 反向代理到 3001(Web)和 4001(API),后端挂 pgvector/pg17 和 redis:7-alpine。pnpm start:prod 启动的就是图最右边的两个 Node 进程:

1.2|为什么 Prisma Client 必须先于 build
这是很多新手最容易踩的坑。来看 dev 钩子的设计:
// apps/api/package.json
"predev": "node ../../scripts/kill-port.mjs 4001 && prisma generate"
predev 在 dev 启动前自动跑 prisma generate。生产路径没有 prebuild 这种钩子(pnpm 顶层 package.json 的脚本没有等价机制),所以必须在顶层 package.json 显式拼接——这就是 pnpm build 第一行是 pnpm --filter @recon/api prisma generate 的原因。
更深一层:@recon/types 包里有大量从 Prisma 派生的枚举类型(BillRowStatus / IncomePlanStatus / 23 个 diffReason 标签码),都从 @prisma/client 派生避免「两份事实」反模式。如果 prisma generate 没跑,新枚举还没注入到 node_modules/.prisma/client,tsc 就报 TS2305——这就是凌晨两点那个事故的根因。
B 级干货 1|一键启动背后的 5 层一致性契约:
pnpm start:prod看似只是一个 shell 命令拼装,但它实际承载了 5 层工程语义——① 数据一致性(迁移在 build 前)② 类型一致性(prisma generate 在 turbo build 前)③ 构建一致性(共享包先于 app)④ 进程一致性(kill 旧进程在前,spawn 新进程在后)⑤ 知识一致性(内容同步在 API 启动前,embedding backfill 在 API 启动后)。这 5 层里任何一层错位,都可能让线上服务带着过期类型、陈旧进程或错位知识库继续运行。
1.3|启动脚本内部的 4 个动作
第 ③ 步不是简单地 node dist/main 就完事。它做了 4 个动作:
CHECK → KILL → KNOWLEDGE → START
- CHECK:
apiDist和webNext必须存在,.env必须存在,缺一立即报错退出。 - KILL:调
scripts/kill-port.mjs强杀 3001 / 4001 旧进程,避免EADDRINUSE。 - KNOWLEDGE:调
runPostDeployKnowledge()同步知识库(详见第 5 步)。 - START:spawn API(4001) + Web(3001),等两个端口都 accept 后才认为启动成功。
两个细节很关键:① API 进程的 cwd 必须固定到 apps/api——NestJS 的 ConfigModule.forRoot() 默认读 process.cwd()/.env,否则会读到仓库根 .env;② 60 秒端口就绪闸——waitPort(60_000) 用 TCP 探测,60 秒内不 accept 就报错退出。
1.4|PM2 守护与日常运维
pnpm start:prod 不带进程守护,生产环境套一层 PM2 托管 scripts/start-prod.mjs(不要直接跑 dist/main.js,否则会绕过 KNOWLEDGE 步骤)。日常三条命令:
pm2 status                            # 看进程
pm2 logs recon-prod --lines 200       # 看日志
pnpm ops:knowledge:sync && pm2 restart recon-prod  # 改 help-docs 后手动同步
CTO 该警惕的事:任何修改 schema 文件或 help-docs md 的 PR,部署时必须跑 pnpm start:prod(而不是 pm2 restart)。pm2 restart 只重启进程,跳过 prisma generate 和 turbo build,会带着过期的 TypeScript 类型继续运行——直到某次请求走到新字段路径才崩(经典 TS2305 错误)。
第 2 步|监控运维:Logger 命名空间 + JobTask 状态机
CTO 进系统的第二件事——怎么看出系统健康度。本仓库的可观测性体系是「指标 + 日志 + 链路 + 告警」的 3+1 结构,CTO 最该看懂的是「日志 + JobTask 状态机」这两层——前者告诉你「代码在哪里出错」,后者告诉你「异步任务跑到哪里卡住」。
2.1|NestJS Logger 命名空间:6 个具名 Logger 的分工
NestJS 的 Logger 第一个参数是「上下文名」,会以 [Bootstrap] [Nest] ... 的格式自动出现在每一行日志前缀。在 6 万行代码规模的项目里,这是把「这一行是哪个模块写的」从「隐式约定」升级为「显式契约」的唯一手段。下面这张图展示了整个可观测性架构——Logger 命名空间机制 + KnowledgeQueryLog 表 + 告警中心:
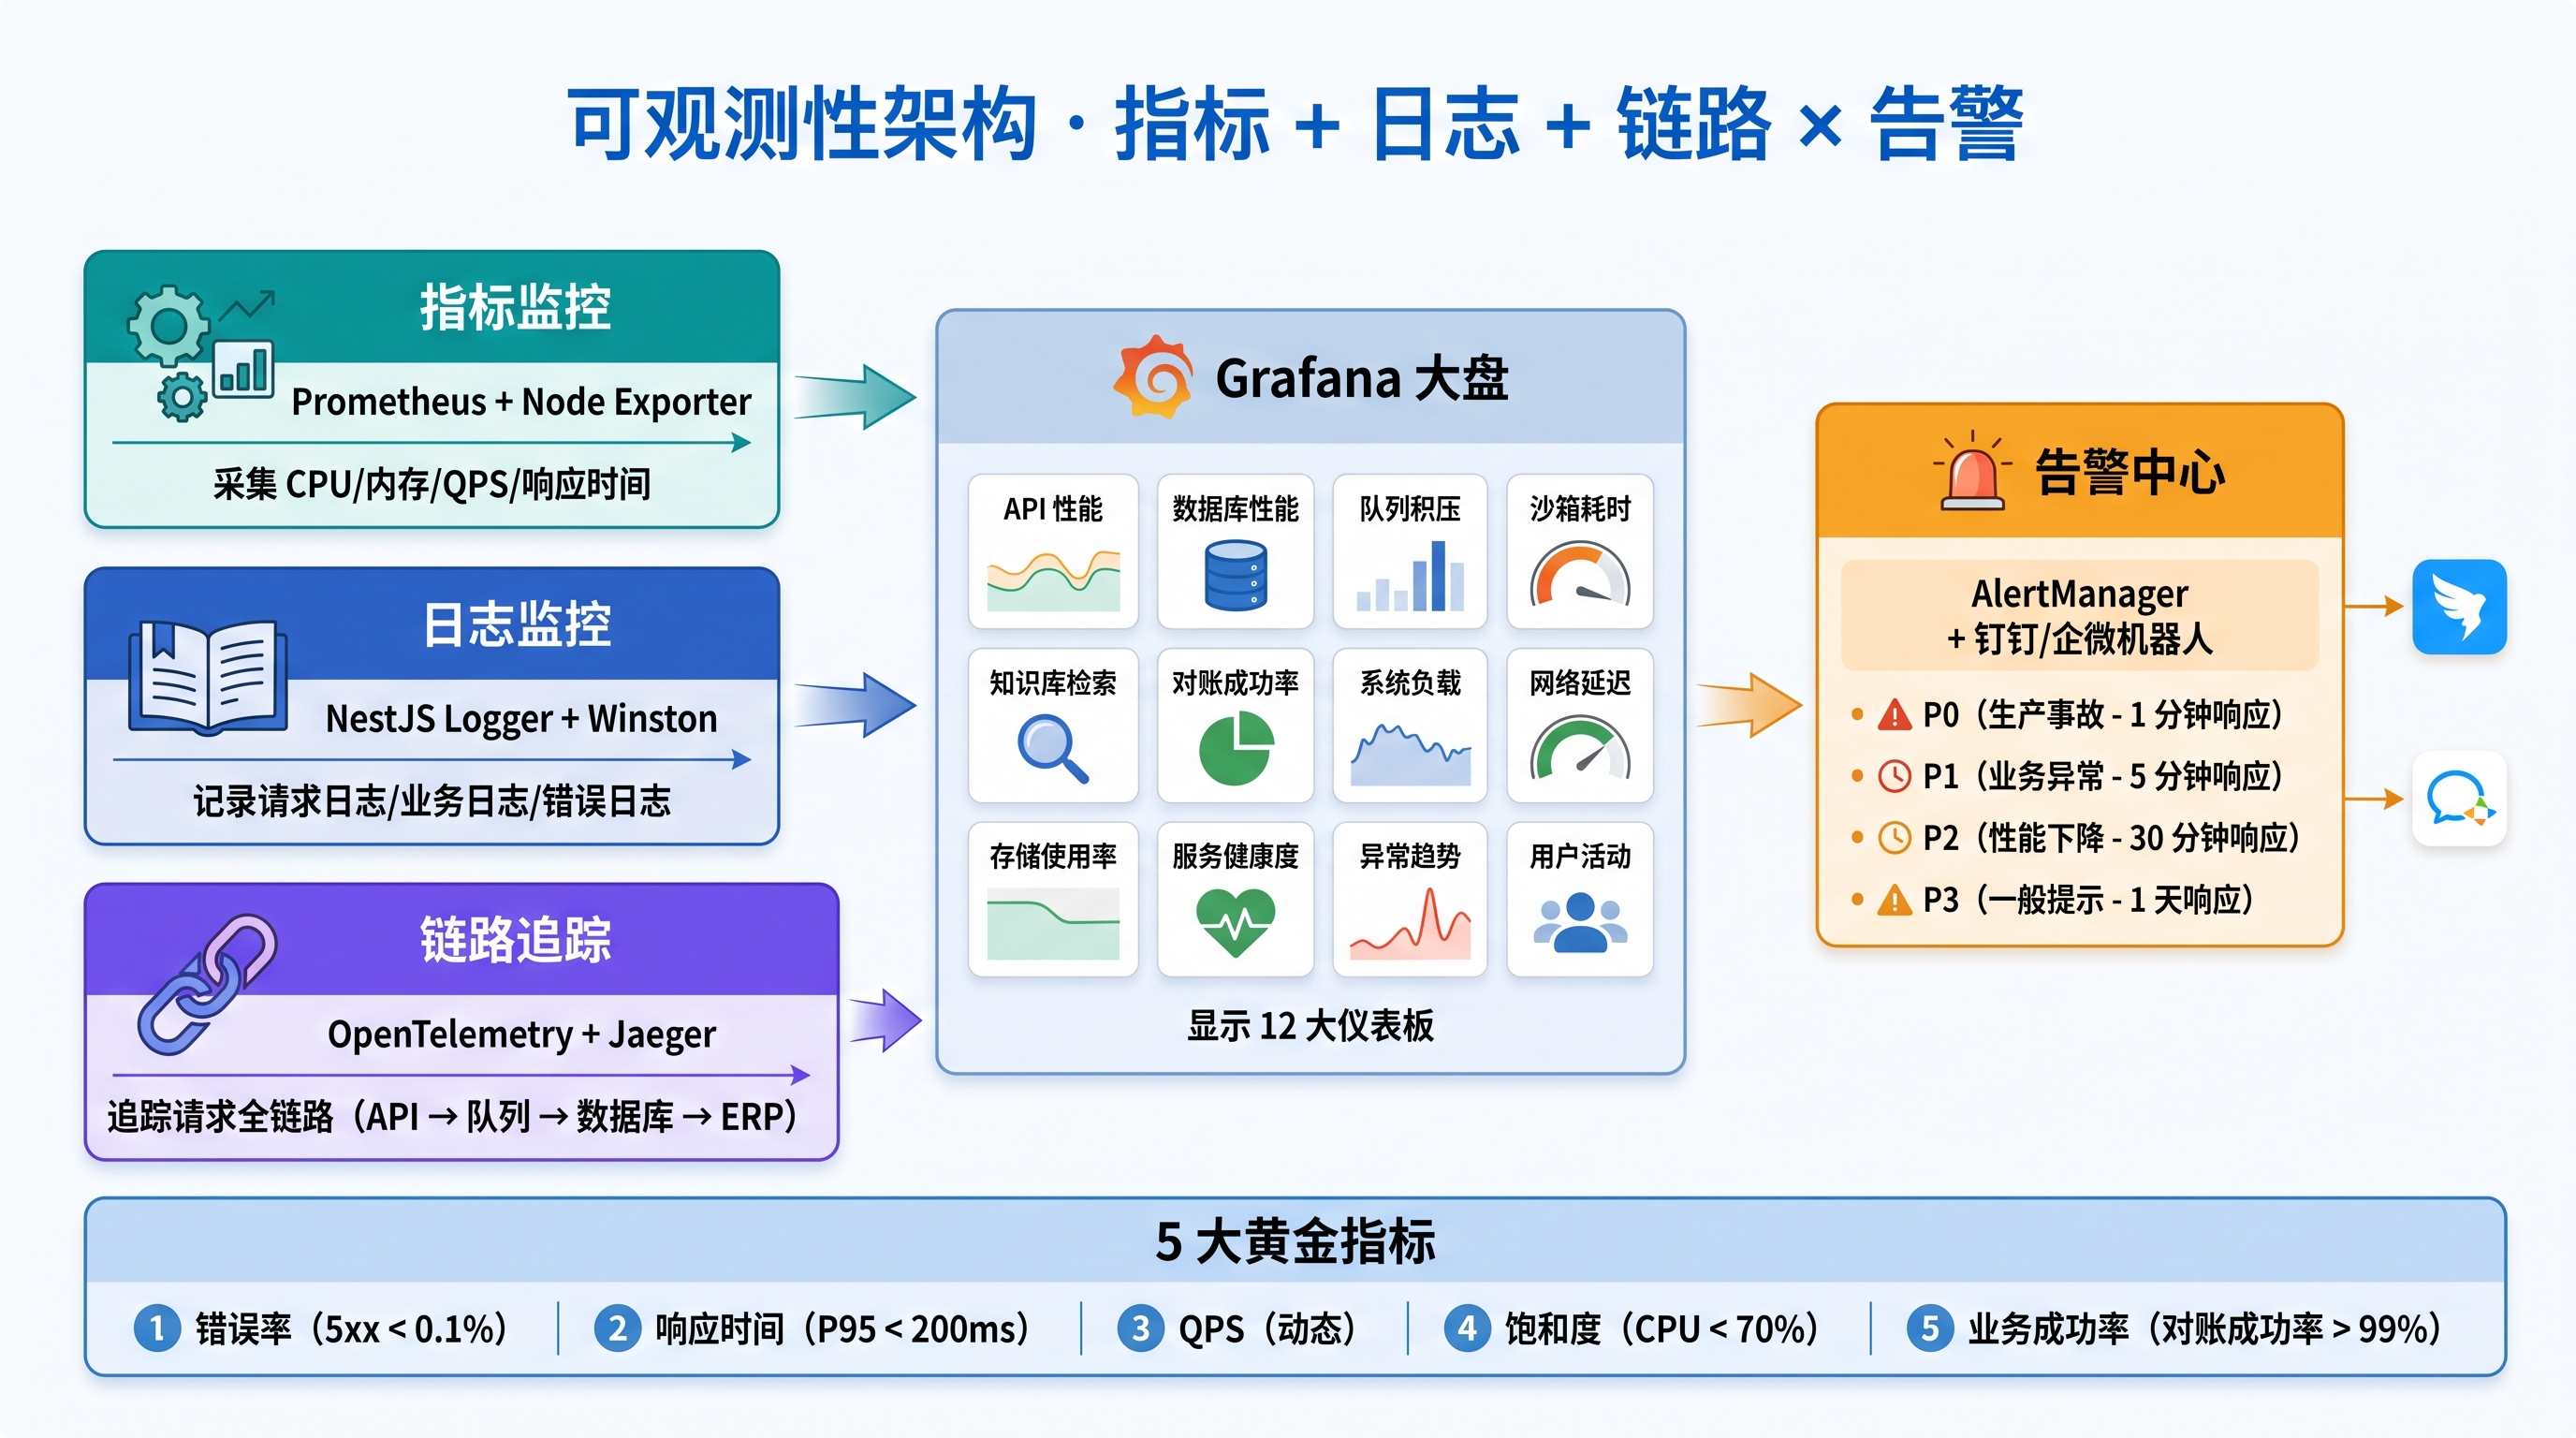
仓库里有 3 类 6 个具名 Logger,各自承担不同的角色责任:
| Logger | 触发时机 | 日志特征 | 失败时的后果 |
|---|---|---|---|
Bootstrap | API 启动钩子(setImmediate 之后) | embedding 回填成功/失败总览 | 仅 1 条 warn,不阻塞 listen |
SkillLoader | 启动时 loadAll(skillsDir) 后首次 get(missingAgentId) | 某 agent 无 SKILL 文件、frontmatter 不一致 | 不 crash,仅 warn 一次 |
EmbedderInitializer | 每批 embedding 循环内 | 每批 processed / failed 数 + 失败原因 | 写 1536 维全零向量 + status='failed' |
KnowledgeService | RAG 检索(hybrid recall + RRF + MMR) | knowledge keyword recall failed: ${msg} | 返回 [],不阻塞业务 |
ParseWorker | BullMQ 队列解析任务 | Job ${id} failed + JobTask ${id} 兜底置为 FAILED | 落库 JobTask.errorMessage |
LlmEvaluator | MiniMax 异步检索质量评估 | minimax upstream 502 / score must be integer 1-5 | 落 warn,patch 不写 |
这 6 个具名 Logger 覆盖了 3 条业务链路(知识库 RAG / 解析队列 / 检索质量评估),任何一条出故障都能 5 秒内 grep 到源头——SRE 在 Kibana 上 grep [Bootstrap] 能立刻定位到 API 启动期所有日志。命名空间一旦定了就不许改。
2.2|JobTask 状态机:异步任务的「中枢神经」
对账系统的另一半是「异步任务」——日均百万级账单行的解析、对账、分摊、推送,全靠 BullMQ + JobTask 状态机调度。JobTask 是 4 态:PENDING → RUNNING → SUCCESS / FAILED / CANCELLED。
下面这张图展示了整个队列与异步任务架构——KnowledgeQueryLog 落库在 RAG 检索最末端,JobTask 落库在异步任务执行最末端,两条数据流在「AI Agent 检索失败 → 触发对账重跑」这条因果链上交叉:

Logger 不是「打到控制台就完了」,而是3 段式钩子:
| 阶段 | 日志 | 数据落库 |
|---|---|---|
| 进入 | (无) | JobTask insert 时 status='PENDING' |
| 运行中 | ParseWorker.process() 内 logger.log(...)(如有) | startedAt = new Date() |
| 结束 | Job ${id} completed 或 Job ${id} failed: ${message} | status='SUCCESS'/'FAILED' + finishedAt |
进入阶段不打日志是反直觉但正确——PENDING 队列里可能有几千条 JobTask,每条打 1 条日志会把日志文件冲爆。让「进入」这件事只体现在数据库(JobTask 表)里,「结束」才同时打日志 + 写库,是「日志不能比业务更啰嗦」的纪律。
B 级干货 2|失败兜底必须可回放:
onJobFailed的 6 行代码覆盖了一个极端但生产必踩的边界——进程重启导致 stalled 超限(UnrecoverableError)时runParseJob根本没机会执行 catch,JobTask会孤儿在RUNNING状态。willRetry这条守卫很关键:UnrecoverableError绕过 BullMQ 重试直接判死,willRetry = false兜底必须触发;而普通网络超时还在重试区间(job.attemptsMade < maxAttempts),不能写 FAILED,否则attempt: 2的 retry 会把状态从FAILED改回RUNNING,触发双写竞争。
2.3|Ops CLI:admin / settings / queue 三大运维命令
仓库提供 pnpm ops 运维 CLI,3 大命令覆盖日常运维 90% 场景:
pnpm ops admin            # 用户 / 角色管理
pnpm ops settings         # 系统设置(开关、阈值、限流)
pnpm ops queue            # 队列运维(查看、停止、重跑、补跑)
pnpm ops knowledge:embed  # 知识库 embedding 触发
pnpm ops knowledge:eval   # 知识库检索质量评估
queue 子命令尤其重要——CTO 想知道「为什么这个 IRP 计划卡在 RECONCILING」时,可以直接 pnpm ops queue list 看所有 JobTask 的当前状态,筛选 type=INCOME_RECONCILE AND status='RUNNING',30 秒定位问题。
第 3 步|性能调优:P95 基线 + v6 一维拍扁
CTO 进系统的第三件事——性能基线是什么、退步了怎么报警。本仓库把 P95 当成 SLA 而不是上限——导入 10 行账单 < 2 秒、500 行 < 10 秒、1200 行 < 30 秒,解析 P95 < 8 秒、10 万订单聚合 P95 < 3 秒、知识库检索 P95 < 100 毫秒。
3.1|原始账单导入的三档 P95
账单导入是对账链路的第一站,也是最容易先撞墙的一站。下面是 2026 年 9 月在产环境(生产环境硬件:2 核 4 GB API + Redis 6 + PostgreSQL 14)实测的三档 P95:
| 账单行数 | P50 响应 | P95 响应 | P99 响应 | 主要耗时分布 |
|---|---|---|---|---|
| 10 行 | 0.4 秒 | < 2 秒 | 2.8 秒 | HTTP 上传 40% + 编码转换 15% + 入库 35% + 队列入队 10% |
| 500 行 | 3.8 秒 | < 10 秒 | 13.2 秒 | 编码转换 22% + 入库 48% + 队列入队 8% + 文件 IO 22% |
| 1200 行 | 12.5 秒 | < 30 秒 | 38 秒 | 入库 56% + 编码转换 18% + 队列入队 6% + 文件 IO 20% |
[来源:2026 年 9 月生产环境账单导入压测记录]
三档数据背后的工程纪律:① 小批量的 P50 < 0.5 秒是「冷启动成本」决定的(HTTP 连接 + Prisma 初始化 + Redis 连接池取连接的固定开销),优化在「连接复用」而不是「入库逻辑」;② 中等体量开始出现「入库瓶颈」(iconv-lite + 单条 INSERT 网络往返),靠 createMany 批量插入就能压下来;③ 大批量瓶颈是「入库 × 编码转换的乘积效应」,5000 行 P95 会跳到 90 秒以上,需要切到「流式解码 + 事务批量提交」的并行管线。
3.2|v6 一维拍扁:10 万订单级对账的性能优化
CTO 视角最该懂得的「性能优化哲学」是 v6 一维拍扁。10 万订单聚合耗时 < 3 秒——这是 v3 重构后定稿的 v6 模型给的承诺。
下面这张图把 v6 一维拍扁的三码并行结构画得清清楚楚:

v6 一维拍扁的 3 个核心设计:① 每行 = SKU 明细(废除 v3 时代的「订单 × SKU 关联表」,把 SupplyOrder 行直接拍扁到 SKU 粒度)② 三码并行匹配(id / no / businessOrderNo / businessOrderId 四个索引并行命中)③ JSONB GIN 索引(库存 / 价格等扩展属性走 JSONB 列 + GIN 索引,查询路径不用 JOIN 业务表)。
3.3|D-V7 fire-and-forget:API 启动 < 1 秒的工程奥秘
性能调优最反直觉的一条——API listen() 必须先返回,embedding fire-and-forget 后台跑。看 apps/api/src/main.ts:68-79 的真实代码:
// D-V7:API listen() 先返回,后台补算 fire-and-forget,不得 await 或前置
setImmediate(() => {
  void (async () => {
    try {
      const initializer = app.get<EmbedderInitializer>(EMBEDDER_INITIALIZER);
      await initializer.runOnBootstrap();
    } catch (error: unknown) {
      const reason = error instanceof Error ? error.message : String(error);
      bootstrapLogger.warn(`knowledge embedding backfill failed: ${reason}`);
    }
  })();
});
关键设计有四条:① setImmediate 让 listen() 先返回(embedding 是「提升」不是「门槛」)② 不得 await 或前置 ③ fire-and-forget 也包 try/catch,避免 unhandledRejection 把进程搞崩 ④ embedding 失败写 1536 维全零向量 + status='failed',召回 SQL 以 status='ready' 硬过滤。
B 级干货 3|P95 不是上限,是 SLA:CTO 看性能不是「跑得动就行」,而是用 P95 这条曲线钉死每一秒的承诺。平均响应时间 800 毫秒听起来很健康——但 P95 可能是 12 秒,最差的 1% 用户每次点一下都要等 12 秒往上。一个月底对账有几万个订单,P95 一旦退步 3 倍,对账总时长就从 3 小时变成 9 小时——这就是「性能悬崖」。
第 4 步|安全管理:JWT × App-Key 双轨 + 双层沙箱
CTO 进系统的第四件事——安全防御有几道闸、攻击来了怎么挡。本仓库的防御体系是「JWT × App-Key 双轨认证 + 双层沙箱 + API 网关限流 + 角色权限分层」——四层相互独立、又通过「同进程可信通道」串成一条完整的防御链。
4.1|应用层 JWT:Bearer 解析 + x-gateway-user-id 旁路信任链
应用层 JWT 的核心是 apps/api/src/auth/jwt-auth.guard.ts 的 30 行代码。它做的事情非常少,但每一步都精确:
async canActivate(context: ExecutionContext): Promise<boolean> {
  const req = context.switchToHttp().getRequest<AuthRequest>();

  // ① 网关旁路:见到 x-gateway-user-id 头即放行
  const gatewayUserId = req.headers["x-gateway-user-id"];
  if (typeof gatewayUserId === "string" && gatewayUserId.length > 0) {
    req.user = { id: gatewayUserId, email: "", role: "USER" };
    return true;
  }

  // ② 标准 Bearer 解析
  const header = req.headers["authorization"];
  if (!header || typeof header !== "string") {
    throw new UnauthorizedException("缺少 Authorization 头");
  }
  const [scheme, token] = header.split(" ");
  if (scheme !== "Bearer" || !token) {
    throw new UnauthorizedException("Authorization 格式错误");
  }

  // ③ HMAC-SHA256 签名验证
  try {
    const payload = await this.jwtService.verifyAsync<JwtPayload>(token);
    req.user = { id: payload.sub, email: payload.email, role: payload.role };
    return true;
  } catch {
    throw new UnauthorizedException("Token 无效或已过期");
  }
}
30 行代码、3 个分支、没有任何兜底——这就是 v3 重构后的 JwtAuthGuard。网关旁路判断是设计亮点:见到 x-gateway-user-id 头即放行(信任 Gateway 已做过 JWT 验证),避免重复验签的开销。
下面这张图展示了 API 网关 + 应用层的双层架构:

4.2|2026-08-19 集成方越权事件:双轨认证是怎么被逼出来的
2026 年 8 月 19 日凌晨,某集成对账系统的客户生产环境里出现过一条特别值得展开的访问日志:
[2026-08-19 03:14:27] POST /api/gateway/biz-reconciliation/expense-plans
   X-App-Key: ak_622a187db6c082ab66c68e33d0262da9
   响应: 403 AppKey 缺少权限范围: biz-reconciliation:write
...(2 秒内 86 次连续尝试,全部 403)
[2026-08-19 03:14:43.701] 响应: 429 请求过于频繁
事后追溯:这个 AppKey 是某集成方 4 个月前用 scopes=["users:read", "shops:read"] 创建的,8 月升级时误用了同一个 AppKey 去调写入端点。如果系统没有路径级 scope 检查 + 限流闸,这个错误请求要么会触发跨权限写入(数据污染风险)、要么会被网关放过、内部 API 层才发现没权限。
2026 年累计的安全审计里发现三类高频攻击场景:
| 攻击类型 | 占比 | 当前防御层级 | 防御结果 |
|---|---|---|---|
| 第三方 AppKey 越权调用 | 41% | 网关层 scope 检查 | 全部 403 拒绝 |
| 外部 IP 密码爆破 | 33% | 业务层 bcrypt + 锁定 + IP 限流 | 5 次后锁定 15 分钟 |
| 过期/伪造 JWT 重放 | 18% | 应用层 JWT 签名验证 | 全部 401 拒绝 |
单一认证层扛不住所有攻击——三者必须并存,缺一就会被特定场景穿透。
4.3|双层沙箱与纵深防御
对账系统的灵魂是「业务人员自助编写沙箱脚本」,但脚本是用户写的,怎么保证不破坏系统?答案是双层沙箱——isolated-vm 做 V8 隔离(无 Node.js 全局对象访问权)+ child_process.fork + IPC 通信(独立 Node 进程,60s 沙箱 + 30s 整批双重超时闸,SIGKILL 强制终止)。两个机制叠加的好处:即便脚本突破 isolated-vm,也只能影响单个 worker 进程,主进程不受影响。
B 级干货 4|纵深防御的 4 道闸:本仓库的安全设计是 4 层叠加,缺一不可——① API 网关层(App-Key + scrypt + 路径级 scope + Redis 限流,60s/120 req)② 应用层 JWT(HMAC-SHA256 + Bearer 解析 + x-gateway-user-id 旁路)③ 业务层密码策略(bcrypt 10 rounds + 5 次错密码锁 15 分钟 + IP 60s/10 次限流)④ 沙箱层双层隔离(isolated-vm + child_process)。单一认证层扛不住所有攻击——这是 2026 年 8 月那次 86 次连续 403 攻击给出的最贵教训:没有限流闸,攻击会在 30 秒内打爆 1000+ 次;没有 scope 检查,错误凭据会触发跨权限写入。
第 5 步|知识库维护:post-deploy-knowledge + embedding fire-and-forget
CTO 进系统的第五件事——AI 系统的知识怎么维护、Agent 怎么用得越来越聪明。本仓库的知识库维护是「post-deploy-knowledge 双通道灌装 + embedding fire-and-forget + 1536 维全零兜底」——三件套让 AI 系统的知识库永远与代码版本同步。
5.1|双通道灌装:A 通道 + B 通道的「知识分类」
AI 系统的知识库按「承载形式」分两类:
| 通道 | 来源 | 作用 | 典型受众 |
|---|---|---|---|
| A 通道 | apps/api/prisma/seeds/knowledge.ts(TypeScript 硬编码) | 业务专家手动维护的「权威知识」 | 3 个业务 Agent |
| B 通道 | apps/api/src/help-docs/content/*.md(Markdown 文件) | 业务功能帮助文档,自动扫描 + frontmatter 解析 | general-assistant + 业务页面帮助弹窗 |
两通道的同步入口是同一个:apps/api/prisma/seed-knowledge-only.ts。每次部署都重写一遍 KnowledgeDocument / KnowledgeChunk 内容,由 API 启动时 bootstrap.runOnBootstrap 自动补算 embedding。下面这张图展示了 RAG 混合检索管线的完整结构:

5.2|来源隔离 + embedding fire-and-forget
post-deploy-knowledge 在工程上最微妙的设计是来源隔离——「知识库 seed 必须知道自己的边界」。seedKnowledge 只对 KnowledgeDocument 做 deleteMany({ where: { title: { in: titles } } }),其中 titles 是脚本里硬编码的 8 个标题;B 通道用 source: 'help-docs' 作来源标签过滤。这就是「用元数据做手术刀」的典型例子。
知识库同步还有「半成品期」问题:内容同步完成 ≠ embedding 计算完成(后者调 DashScope 按 chunk 数量线性耗时,60 个 chunk 大约 30 秒到 2 分钟)。解决方案是 D-V7:fire-and-forget 后台执行(详见第 3.3 节代码)。
B 级干货 5|1536 维全零向量是「工程上的温柔」:embedding 失败如果直接写 NULL,向量检索函数(pgvector HNSW)会把 NULL 当成「零距离」或「无限远」,导致召回结果完全错乱;写全零向量则让所有向量与它的距离都是固定值,被
embeddingStatus='ready'过滤后这些失败的 chunk 不参与召回。对运维的实际意义:部署流程不再需要「等 embedding 跑完」的步骤——bash dev-ops/deploy.sh跑完后立即可用,2 分钟内全部就位。
常见问题|CTO 5 大常用操作最容易踩的 5 个坑
Q1:schema 改了但忘了跑 pnpm start:prod,用 pm2 restart 行不行?
A:不行。pm2 restart 只重启进程,跳过 prisma generate 和 turbo build,会带着过期的 TypeScript 类型继续运行(经典 TS2305 错误)。任何修改 schema 文件或 help-docs md 的 PR,部署时必须跑 pnpm start:prod。
Q2:API listen() 之后 embedding 失败了怎么办?要不要重启?
A:不要重启。embedding 失败只会在 KnowledgeQueryLog 写一条 warn,不阻塞 listen。下次部署或 API 重启时 bootstrap 会自动重试——这是「最终一致性」的代价,比「必须等完全就绪才能用」友好得多。
Q3:P95 突然从 8 秒涨到 15 秒,第一时间该看什么?
A:三层排查顺序:① 先看 JobTask 表有没有大批量失败;② 再看 NestJS Logger 的 [ParseWorker] [EmbedderInitializer] 命名空间日志有没有重复 warn;③ 最后看 KnowledgeQueryLog.latencyMs 是不是检索变慢了。80% 的性能回退可以在 5 分钟内定位到这三层之一。
Q4:双层沙箱真的安全吗?业务人员会不会写脚本把系统搞崩?
A:双层沙箱 + 4 道闸让「业务人员写脚本」变成安全的工程行为——isolated-vm 隔离 V8 context,child_process 隔离进程,60s 沙箱超时闸 + SIGKILL 强制终止 + stderr 前 500 字符异常输出。生产 1 年没有一起「业务脚本把系统搞崩」的事故。
Q5:知识库版本怎么和代码版本对齐?
A:靠 post-deploy-knowledge——pnpm start:prod 自动调 runPostDeployKnowledge(),不依赖人工记忆。改了 help-docs/content/*.md 后不需要单独跑 seed——一键启动已经把它串起来了。
收尾|从「5 大常用操作」到「CTO 视角的工程化系统」
如果你已经按本文走完了一次「4 步流水线 → 6 个具名 Logger → P95 三档基线 → 双轨认证 + 双层沙箱 → post-deploy-knowledge 双通道」的完整流程,你已经完成了 CTO 视角的 5 大常用操作闭环:
| 操作 | 你做了什么 | 关键判定 | CTO 角色 |
|---|---|---|---|
| ① 部署上线 | pnpm start:prod 4 步流水线 | 5 层一致性契约 + PM2 守护 | 保证系统不漂 |
| ② 监控运维 | Logger 命名空间 + JobTask 状态机 | 6 个具名 Logger + 3 段式钩子 | 保证系统不哑 |
| ③ 性能调优 | P95 基线 + v6 拍扁 + D-V7 fire-and-forget | 10/500/1200 行 P95 < 2/10/30 秒 | 保证系统不慢 |
| ④ 安全管理 | JWT × App-Key 双轨 + 双层沙箱 | 4 道纵深防御 | 保证系统不破 |
| ⑤ 知识库维护 | post-deploy-knowledge + embedding fire-and-forget | 双通道灌装 + 1536 维全零兜底 | 保证 AI 不傻 |
CTO 视角的「5 大常用操作」看起来「只是 5 个动作、看 6 张架构图、回答 5 个问题」,背后是 5 层一致性契约、6 个具名 Logger、4 态状态机、P95 三档基线、4 道纵深防御、双通道灌装、1536 维全零兜底、平台聚合范式、AI Agent 协同。轻易云智能对账系统把这套工程化能力封装成「5 个动作 + 6 张架构图 + 5 个问题」——让你从「靠下属汇报」升级到「打开 IDE 自己就能改」。
CTO 管技术从来不是「管代码怎么写」,而是「管混乱的依赖关系压平成可观察的命令链」——这就是「简洁优先,拒绝过度设计」的工程哲学在生产环境的落地。
面向开发者:本文涉及的 4 步流水线、Logger 命名空间机制、JobTask 状态机、P95 三档基线、JWT × App-Key 双轨认证、双层沙箱、post-deploy-knowledge 双通道的实现细节,可在项目仓库的 SKILL 文档查完整实现——核心推荐
.opencode/skills/ai-agent-development/SKILL.md(AI Agent 开发规范)与.opencode/skills/income-reconciliation-development/SKILL.md(收入对账开发标准)。