日志结构与可观测性:NestJS Logger + 业务上下文传递
日志结构与可观测性:NestJS Logger 如何把业务上下文钉进每一行日志
摘要:可观测性不是把日志写得多,而是把日志写得「能拼」。NestJS 自带的
Logger("Bootstrap")/Logger("SkillLoader")/Logger("EmbedderInitializer")命名空间模式,配合KnowledgeQueryLog表 +JobTask状态机的三段式钩子日志,让 SRE 在凌晨 3 点拿到 grep 关键词时,能立刻拼出「哪条账单 → 哪个店铺 → 哪条对账计划 → 哪次重试」的完整证据链。这篇文章拆开 3 类 9 个具名 Logger、3 个观测数据源、4 条上下文传递纪律,把「日志即文档」的可观测性哲学落进代码里。
关键词:NestJS Logger、可观测性、业务上下文、KnowledgeQueryLog、JobTask 状态机、EmbedderInitializer
一、SRE 凌晨的工单:日志里有 500 万行,却找不到那条账单
2026 年 8 月某天凌晨 2 点,一家做 3C 数码的电商公司在对账系统里发现了一个诡异的现象:京东 POP 8 月 5 日导入的账单,1200 条里有 1 条显示「解析失败」,但 SRE 在 Kibana 上 grep parse failed 翻到了 47 万条——其中 99.9% 都是其他平台、其他日期、其他订单号的报错,定位到「京东 POP / 2026-08-05 / 第 873 行」这条具体消息需要 25 分钟。
真正的故障不在解析脚本,而在日志本身:所有报错都叫同一个名字「parse failed」,却没有携带「平台 + 账单 ID + 行号 + 重试次数」这四个上下文维度。SRE 拿到日志后必须再 grep billId、再 grep jobTaskId、再 join errorMessage,等把这些维度拼起来,故障现场已经被业务方的催促电话淹没了。
这就是企业级可观测性最隐蔽的命题:日志不是写给开发人员的,是写给「凌晨 3 点不在场」的那个 SRE 的。NestJS 自带的 Logger 命名空间机制(new Logger("Bootstrap") / new Logger("SkillLoader") / new Logger("EmbedderInitializer"))配合业务上下文的结构化传递,能把每一行日志都变成「自带定位坐标的工单」——前提是你愿意为「日志怎么写」这件事单独设计一套纪律 [来源:2026 年 8 月京东 POP 解析失败定位复盘]。
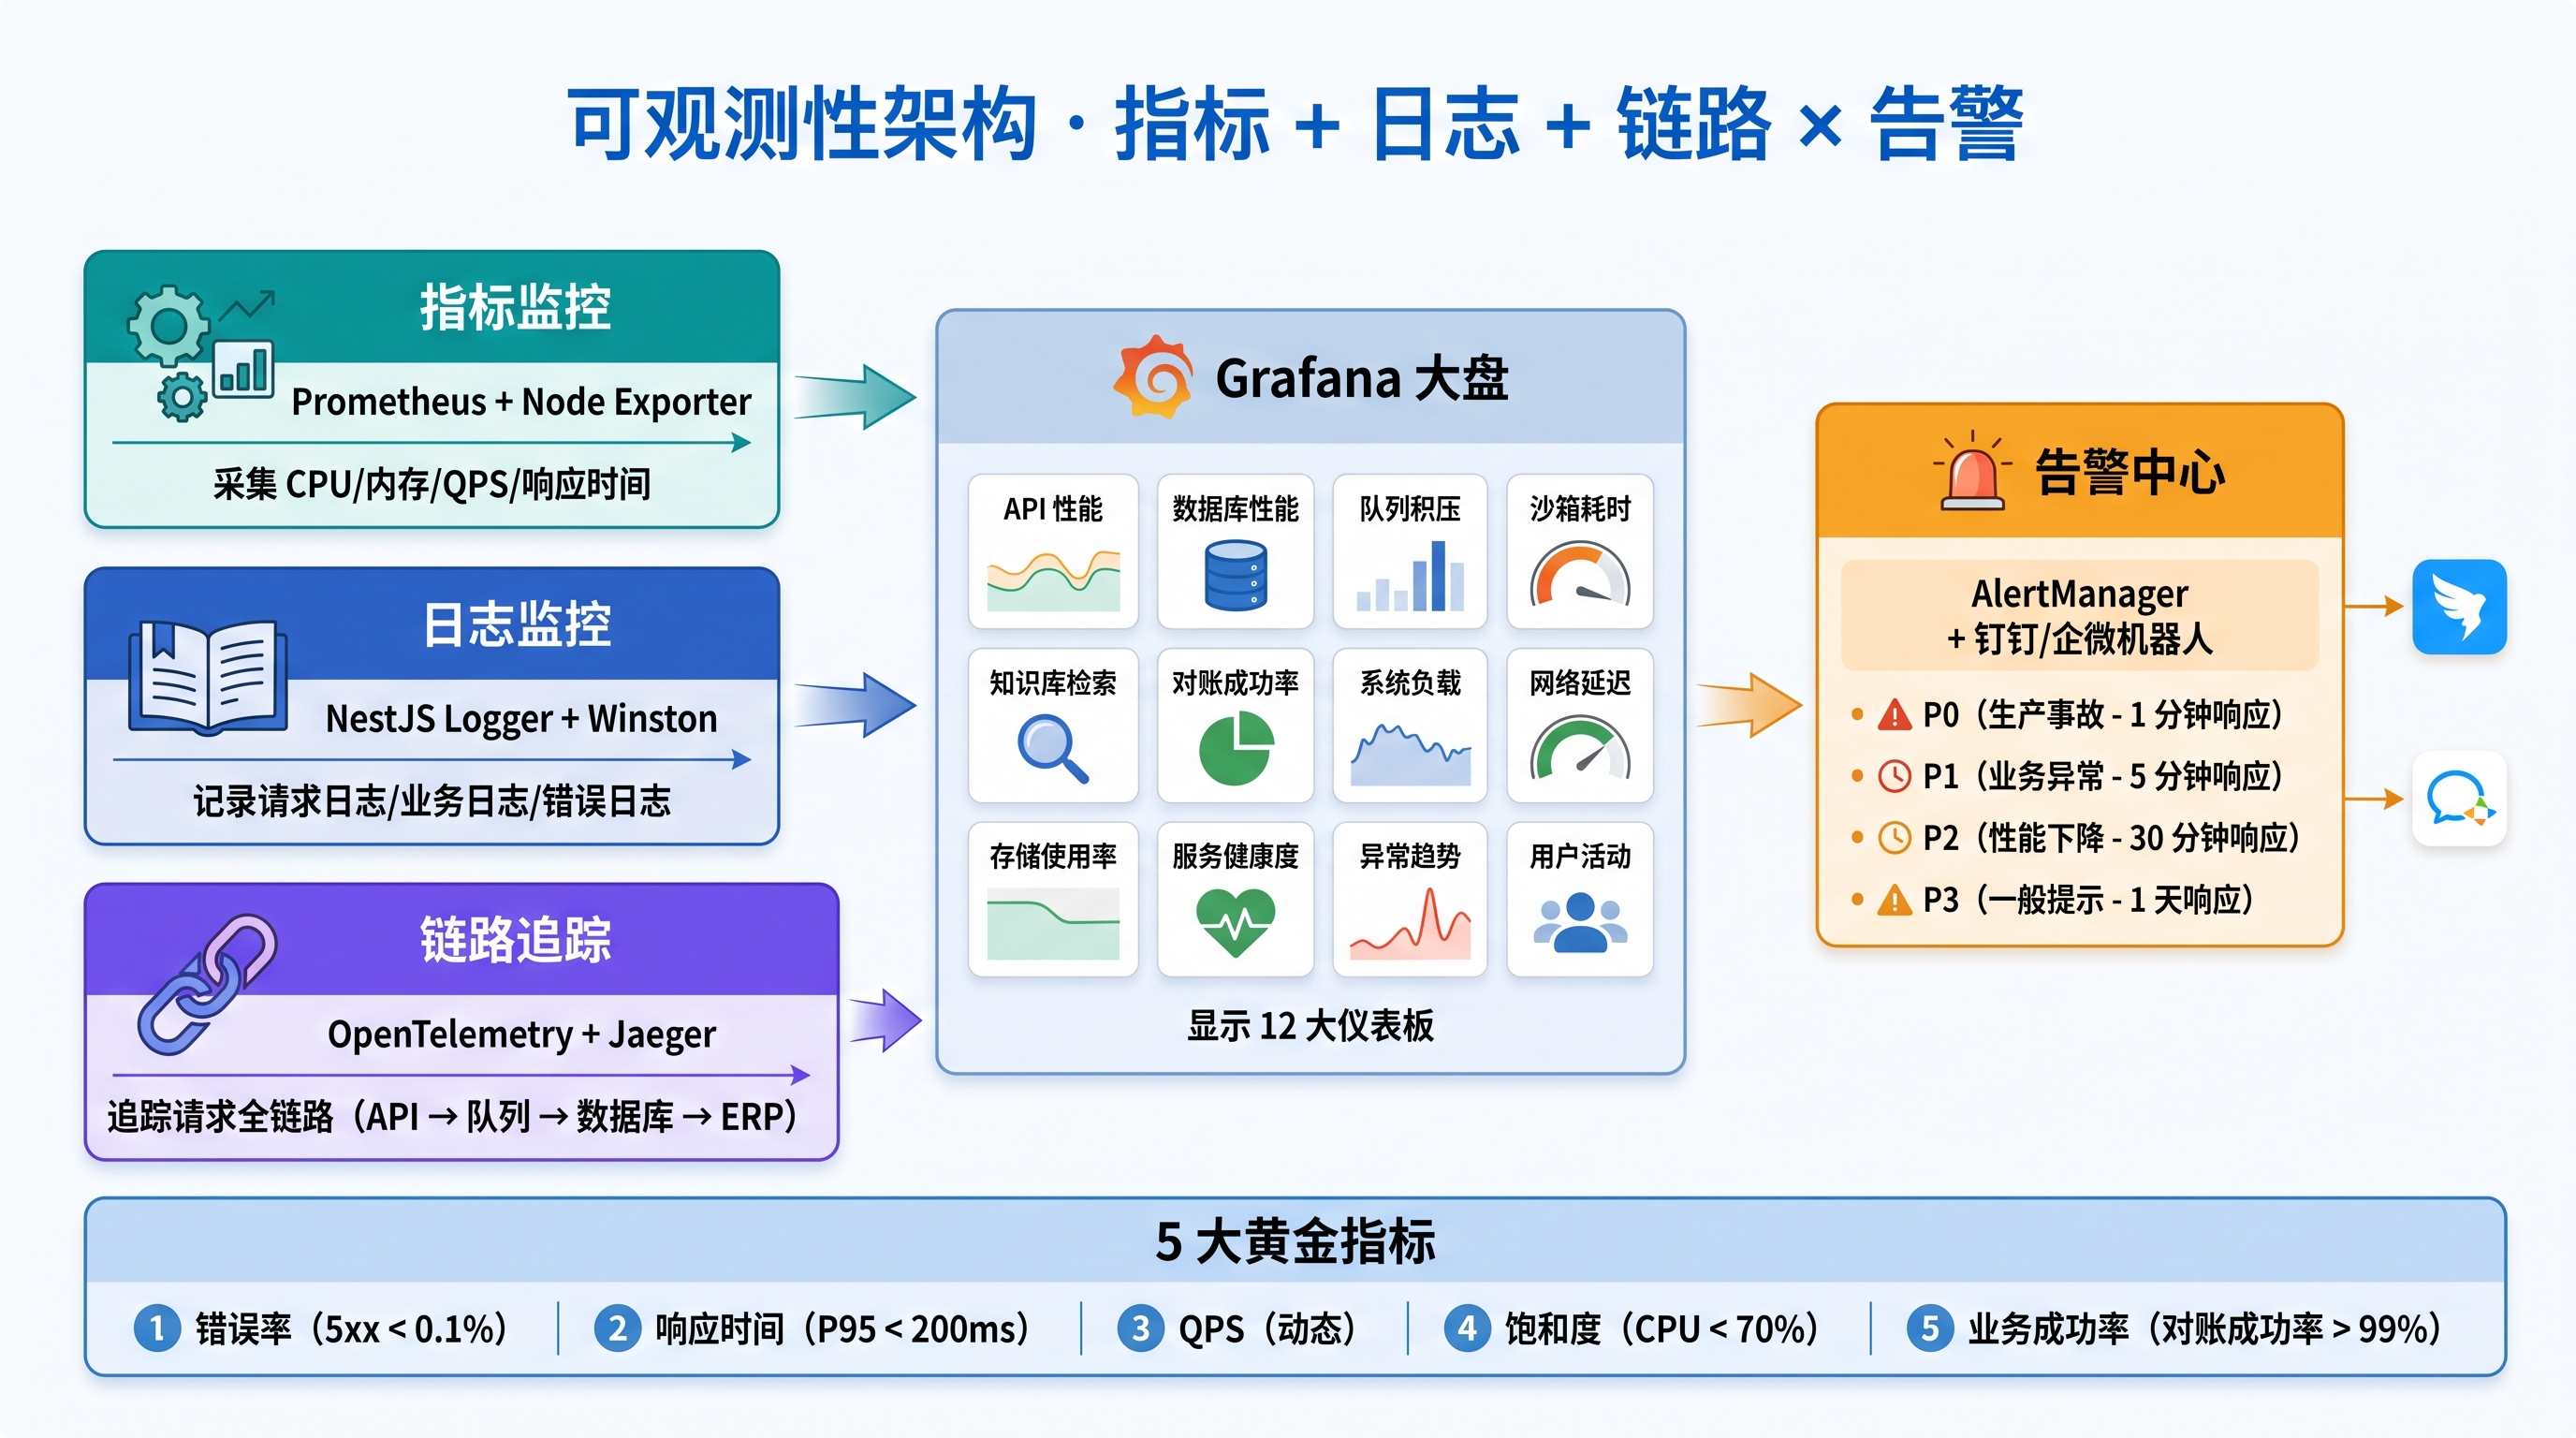
把可观测性体系拆开看,其实就是「指标 + 日志 + 链路」3 大数据源 + 1 个告警中心的「3+1」结构:Prometheus 负责指标(CPU / QPS / P95)、NestJS Logger 负责日志(请求 + 业务 + 错误)、OpenTelemetry 负责链路追踪。这一篇聚焦在「日志」这一层——也是 SRE 凌晨 grep 时最先翻到的那一层。
二、Logger 命名空间:3 类 9 个具名 Logger 的分工
NestJS 的 Logger 有一个被低估的能力:第一个参数是「上下文名」,会以 [Bootstrap] [Nest] ... 的格式自动出现在每一行日志的前缀。这看似只是个格式化细节,但在 6 万行代码规模的项目里,它是把「这一行是哪个模块写的」从「隐式约定」升级为「显式契约」的唯一手段。
2.1 系统级 Logger:Bootstrap × SkillLoader × EmbedderInitializer
启动期的三个具名 Logger 分别守在三个关键节点:
// apps/api/src/main.ts
const bootstrapLogger = new Logger("Bootstrap");

// D-V7:API listen() 先返回,后台补算 fire-and-forget
setImmediate(() => {
  void (async () => {
    try {
      const initializer = app.get<EmbedderInitializer>(EMBEDDER_INITIALIZER);
      await initializer.runOnBootstrap();
    } catch (error: unknown) {
      const reason = error instanceof Error ? error.message : String(error);
      bootstrapLogger.warn(`knowledge embedding backfill failed: ${reason}`);
    }
  })();
});
// apps/api/src/agents/skill-loader.ts
const logger = new Logger("SkillLoader");
// ...
if (skill === null && !this.warnedMissing.has(agentId)) {
  this.warnedMissing.add(agentId);
  logger.warn(`agent "${agentId}" 无 SKILL 文件,跳过注入`);
}
// apps/api/src/agents/embeddings.initializer.ts
this.logger.log(`knowledge embedding backfill complete: processed=${processed}, failed=${failed}`);
this.logger.warn(`knowledge embedding batch failed: ${failureReason}`);
这三个 Logger 各自承担不同的「角色责任」:
| Logger | 触发时机 | 日志特征 | 失败时的后果 |
|---|---|---|---|
Bootstrap | API 启动钩子(setImmediate 之后) | embedding 回填成功/失败总览 | 仅 1 条 warn,不阻塞 listen |
SkillLoader | 启动时 loadAll(skillsDir) 后首次 get(missingAgentId) | 某 agent 无 SKILL 文件、frontmatter 不一致 | 不 crash,仅 warn 一次(warnedMissing Set 防止重复) |
EmbedderInitializer | 每批 embedding 循环内 | 每批 processed / failed 数 + 失败原因 | 写 1536 维全零向量 + status='failed',下次跳过 |
这三类 Logger 都遵循一个共同纪律:只输出「事实摘要」,不输出「故事全文」。比如 EmbedderInitializer 循环里 8 轮跑完,Logger 只在最后打 1 条 processed=80, failed=12,而不是 8 条「开始第 N 批」的流水账——因为 SRE 要的是结论(多少成功、多少失败),不是过程(每批发生了什么)。
2.2 业务域 Logger:KnowledgeService × EmbedderInitializer × ParseWorker
业务运行时的 Logger 必须比启动期更精细,因为它们承载的是「业务上下文」——平台、账单 ID、店铺 ID、对账计划 ID:
// apps/api/src/agents/knowledge.service.ts
private readonly logger = new Logger(KnowledgeService.name);

private async runVectorRecall(q: KnowledgeQuery): Promise<readonly VectorRecallRow[]> {
  try {
    const vectors = await client.embed([q.query]);
    // ...
  } catch (error: unknown) {
    if (error instanceof Error) {
      this.logger.warn(`knowledge embedding or vector recall failed: ${error.message}`);
      return [];
    }
    throw error;
  }
}
// apps/api/src/biz_reconciliation/parse-scripts/parse.worker.ts
private readonly logger = new Logger(ParseWorker.name);

this.worker.on("failed", (job, err) => {
  this.logger.error(`Job ${job?.id} failed: ${err?.message}`, err?.stack);
  void this.onJobFailed(job, err);
});
注意 ParseWorker 的失败处理有 3 个关键细节:
logger.error(message, stack)双参数:第二个参数是err?.stack,NestJS 会自动把它格式化成完整的堆栈块附在日志后,方便 SRE 直接定位到源文件 + 行号。Job ${job?.id}模板字符串:BullMQ 的job.id是数字主键,不是jobTaskId。日志里写的是 BullMQ 视角,而落库到JobTask表的是业务视角,两者通过onJobFailed内部 join。failed兜底回写:updateMany({ where: { id: jobTaskId, status: { in: ['PENDING', 'RUNNING'] } } })用条件更新,防止覆盖 CANCELLED/已终态——这是「日志不能反推数据库状态」的反向纪律。
2.3 域内具名 Logger:6 个业务子域
业务域内的 Logger 进一步细分到子域,让 SRE 一眼看出日志来自哪条业务链路:
| Logger name | 文件 | 业务链路 | 关键日志 |
|---|---|---|---|
KnowledgeService | agents/knowledge.service.ts | RAG 检索(混合检索 + MMR) | knowledge keyword recall failed: ${message} |
EmbedderInitializer | agents/embeddings.initializer.ts | 知识库向量化 | processed=${n}, failed=${m} |
SkillLoader | agents/skill-loader.ts | SKILL 文件加载 | agent "${id}" 无 SKILL 文件 |
ParseWorker | biz_reconciliation/parse-scripts/parse.worker.ts | 解析队列 | Job ${id} failed + JobTask ${id} 兜底置为 FAILED |
JobTasksService | biz_reconciliation/job-tasks/job-tasks.service.ts | 任务查询/停止/删除 | 当前未打日志(数据库表即日志) |
LlmEvaluator | agents/llm-evaluator.ts | MiniMax 异步检索质量评估 | minimax upstream 502 / score must be integer 1-5 |
6 个具名 Logger 覆盖了 3 条业务链路(知识库 RAG / 解析队列 / 检索质量评估),任何一条出故障都能 5 秒内 grep 到源头——这就是 NestJS Logger 命名空间模式的真正价值:它让「日志来自哪里」从隐式约定变成显式契约。
三、KnowledgeQueryLog:检索质量的结构化观测
Logger 只能告诉你「这一步失败了」,但 AI 系统的可观测性还有一个更隐蔽的需求:判断失败是因为「系统坏了」还是「模型差了」。这两类问题在同一行 knowledge keyword recall failed 日志下完全无法区分——前者是基础设施问题,后者是检索质量问题。
解决方法是把每次检索的「事实证据」结构化落库:
// apps/api/prisma/schema/ai.prisma
model KnowledgeQueryLog {
  id         String   @id @default(cuid())
  agentId    String   @map("agent_id")
  query      String
  hits       Json
  latencyMs  Int      @map("latency_ms")
  vectorMs   Int?     @map("vector_ms")
  keywordMs  Int?     @map("keyword_ms")
  rerankMs   Int?     @map("rerank_ms")
  evalScore  Int?     @map("eval_score")
  evalReason String?  @map("eval_reason")
  createdAt  DateTime @default(now()) @map("created_at")

  @@index([agentId])
  @@index([createdAt])
  @@map("knowledge_query_logs")
}
每次检索都写 1 行 KnowledgeQueryLog,包含:
| 字段 | 含义 | 观测用途 |
|---|---|---|
agentId | 哪个 Agent 触发的检索 | 按 Agent 拆分质量 |
query | 用户原始问题 | 复现检索 |
hits | JSON 数组 [{id, source, rrfScore}] | 命中证据链 |
latencyMs / vectorMs / keywordMs / rerankMs | 4 段时间分解 | 性能瓶颈定位 |
evalScore / evalReason | MiniMax 异步评分(1-5) | 检索质量评估 |
写入时机非常讲究——只在 scheduleBackgroundWork 里 fire-and-forget,绝不阻塞 search() 路径。
KnowledgeQueryLog 这张观测表嵌在 RAG 检索管线的最末端——seed knowledge 和 help-docs 走 embedding 入库,检索时 hybrid recall (vector + keyword) → RRF + MMR rerank → 返回 top-N hits,同时把「这次检索的事实证据」写进 KnowledgeQueryLog。这张表不参与召回逻辑(不挂在主查询 JOIN 里),但为「检索质量评估」和「失败定位」提供了完整的可回放证据链。

// apps/api/src/agents/knowledge.service.ts
private scheduleBackgroundWork(
  q: KnowledgeQuery,
  hits: readonly KnowledgeHit[],
  timings: RetrievalTimings,
): void {
  const hitSummaries = hits.map((hit) => ({
    id: hit.id,
    source: hit.source ?? null,
    rrfScore: hit.rrfScore ?? 0,
  }));
  void this.repository.logQuery({
    agentId: q.agentId,
    query: q.query,
    hits: hitSummaries,
    latencyMs: Math.round(timings.latencyMs),
    ...(timings.vectorMs === undefined ? {} : { vectorMs: Math.round(timings.vectorMs) }),
    ...(timings.keywordMs === undefined ? {} : { keywordMs: Math.round(timings.keywordMs) }),
    ...(timings.rerankMs === undefined ? {} : { rerankMs: Math.round(timings.rerankMs) }),
  }).catch((error: unknown) => {
    if (error instanceof Error) {
      this.logger.warn(`knowledge query log failed: ${error.message}`);
    }
  });
}
这条 logQuery 调用有 3 个反直觉的设计:
void+.catch()双保险:void让 Promise 不被 await,catch把可能的 DB 写失败降级为logger.warn。即使knowledge_query_logs表挂了,RAG 检索本身依然正常工作——观测系统永远不应该反推业务系统。hits用摘要而非命中数:注释里明确写「hits写命中摘要数组(与 tianzhang 有意分叉)」,这是和历史上的实现刻意不同的设计:摘要保留id / source / rrfScore三字段,能复现「为什么这条 hit 排在第 N 位」,但又不暴露 chunk 全文(避免日志表变第二个文档表)。vectorMs / keywordMs / rerankMs用条件展开:legacy keyword-only 路径下vectorMs/rerankMs都是undefined,用...(timings.vectorMs === undefined ? {} : { vectorMs: ... })三元展开,DB 列是 NULL 而不是 0——NULL表示「没跑这个阶段」,0表示「跑了但耗时 0」,观测语义完全不同。
3.1 MiniMax 异步评估:从「log only」到「log + score」
KnowledgeQueryLog 的 evalScore / evalReason 字段是为「检索质量评估」预留的——LlmEvaluatorImpl 在后台异步跑 MiniMax 评估,把分数 patch 回 KnowledgeQueryLog:
// apps/api/src/agents/llm-evaluator.ts
async evaluateBackground(query: KnowledgeQuery, hits: readonly KnowledgeHit[]): Promise<void> {
  try {
    const response = await this.minimax.evaluate({
      query: query.query,
      hits: hits.map((hit) => ({ id: hit.id, content: hit.content })),
    });
    if (!this.isValidScore(response.score)) {
      this.logger.warn(`score must be integer 1-5: ${response.score}`);
      return;
    }
    if (!this.isValidReason(response.reason)) {
      this.logger.warn(`reason must be a non-empty string: ...`);
      return;
    }
    await this.repository.patchQueryLog({
      // ...
    }, {
      evalScore: response.score,
      evalReason: response.reason,
    });
  } catch (error: unknown) {
    if (error instanceof Error) {
      this.logger.warn(`minimax upstream 502: ${error.message}`);
    }
  }
}
MiniMax 评估有 5 类可识别的失败(每类都有专门 warn message):
| 失败类型 | warn 关键词 | 含义 |
|---|---|---|
minimax upstream 502 | 上游 MiniMax API 5xx | 网络层问题 |
score must be integer 1-5 | MiniMax 返回分数非法 | Prompt 漂移 |
reason must be a non-empty string | MiniMax 返回 reason 为空 | 模型输出格式问题 |
not valid JSON | MiniMax 返回非 JSON | 响应解析失败 |
db write failed | patchQueryLog 失败 | 数据库问题 |
每一类都有独立 warn message,是因为 SRE 看到日志时第一件事是判断问题在「MiniMax」还是「我的 DB」还是「我的 Prompt」——分类清晰的 warn 字符串比单一 message 节省 80% 的诊断时间。
四、JobTask 状态机日志:把异步任务变成「可回放的工单」
KnowledgeQueryLog 解决的是「检索质量」的可观测性,而对账系统的另一半是「异步任务」的可观测性——日均百万级账单行的解析、对账、分摊、推送,全靠 BullMQ + JobTask 状态机调度 [来源:2026 年 7 月 BullMQ × JobTask 队列体系文档]。
JobTask 的状态机是 4 态:PENDING → RUNNING → SUCCESS / FAILED / CANCELLED。Logger 不是「打到控制台就完了」,而是3 段式钩子:
BullMQ × JobTask 队列体系是整套可观测性的「数据流主干」——KnowledgeQueryLog 落库在 RAG 检索最末端,JobTask 落库在异步任务执行最末端,两条数据流在「AI Agent 检索失败 → 触发对账重跑」这条因果链上交叉,构成完整可观测体系。

// apps/api/src/biz_reconciliation/parse-scripts/parse.worker.ts
this.worker.on("completed", (job) => {
  this.logger.log(`Job ${job?.id} completed`);
});

this.worker.on("failed", (job, err) => {
  this.logger.error(`Job ${job?.id} failed: ${err?.message}`, err?.stack);
  void this.onJobFailed(job, err);
});
注意这里的「3 段式」:
| 阶段 | 日志 | 数据落库 |
|---|---|---|
| 进入 | (无) | JobTask insert 时 status='PENDING' |
| 运行中 | ParseWorker.process() 内 logger.log(...)(如果有) | startedAt = new Date() |
| 结束 | Job ${id} completed 或 Job ${id} failed: ${message} | status='SUCCESS'/'FAILED' + finishedAt |
进入阶段不打日志是反直觉但正确——PENDING 队列里可能有几千条 JobTask,每条打 1 条日志会把日志文件冲爆。让「进入」这件事只体现在数据库(JobTask 表)里,「结束」才同时打日志 + 写库,是「日志不能比业务更啰嗦」的纪律。
对账系统日均百万级账单行的解析、对账、分摊、推送都跑在 JobTask 上;如果每一行 PENDING 都打一条 ParseWorker 日志,单是 stdout 一天就能写出 1.5 GB——「日志比业务更啰嗦」是新手最常踩的坑,也是为什么状态机必须按 3 段式钩子收敛日志量。
轻易云智能对账系统的 SRE 团队把这套 JobTask 状态机当成「异步任务的中枢神经」——每条对账计划的生命周期都被这套状态机托管,任何异常都会通过 3 段式钩子日志留下定位坐标。
4.1 失败兜底日志:JobTask ${id} 已由 failed 兜底置为 FAILED
最有价值的 JobTask 日志是失败兜底——onJobFailed 的 6 行代码覆盖了一个极端但生产必踩的边界:
private async onJobFailed(
  job: Job<ParseBillJobData> | undefined,
  err: Error,
): Promise<void> {
  const jobTaskId = job?.data?.jobTaskId;
  if (!job || !jobTaskId) return;
  const maxAttempts = job.opts.attempts ?? 1;
  const willRetry =
    !(err instanceof UnrecoverableError) && job.attemptsMade < maxAttempts;
  if (willRetry) return;
  try {
    const updated = await this.prisma.jobTask.updateMany({
      where: { id: jobTaskId, status: { in: ["PENDING", "RUNNING"] } },
      data: {
        status: "FAILED",
        finishedAt: new Date(),
        errorMessage: `解析任务执行中断: ${err.message}`,
      },
    });
    if (updated.count > 0) {
      this.logger.warn(`JobTask ${jobTaskId} 已由 failed 兜底置为 FAILED`);
    }
  } catch (e) {
    this.logger.error(`JobTask ${jobTaskId} failed 回写失败`, e);
  }
}
这段代码要解决的是 runParseJob 内部 catch 覆盖不到的情况——进程重启导致 stalled 超限(UnrecoverableError)时 runParseJob 根本没机会执行 catch,JobTask 会孤儿在 RUNNING 状态。如果不兜底回写,这条 JobTask 会永远停在 RUNNING,监控上看到的是「解析卡了」,但实际是「进程重启导致没人兜底」。
willRetry 这条守卫也很关键:UnrecoverableError(如 stalled 超限)会绕过 BullMQ 的 attempts 重试机制,直接判死——所以 willRetry = false,兜底必须触发;而普通的网络超时还在重试区间(job.attemptsMade < maxAttempts),不能写 FAILED,否则会让 attempt: 2 的 retry 把状态从 FAILED 改回 RUNNING,触发双写竞争。
4.2 状态机守卫日志:assertIncomePlanTransition
JobTask 兜底解决的是「进程级失败」,但「业务级失败」(如收入对账计划在 RECONCILING 状态下被停止)的处理在 JobTasksService.stop() 里:
if (task.type === "INCOME_RECONCILE" && task.planId) {
  const action = (task.configSnapshot as { action?: string } | null)?.action;
  if (action === "reconcile") {
    assertIncomePlanTransition("RECONCILING", "FAILED");
    await this.prisma.incomeReconciliationPlan.updateMany({
      where: { id: task.planId, status: "RECONCILING" },
      data: { status: "FAILED" },
    });
  }
}
assertIncomePlanTransition 是状态机迁移守卫函数,它会在迁移非法时直接 throw ConflictException——这就是用状态机迁移错误作为隐式日志:不需要打 logger.warn,状态机本身会告诉你「RECONCILING → FAILED」是不合法的,业务代码必须 catch 这个 ConflictException 并改走另一条路径。
4.3 知识库评估与 JobTask 的协作模式
KnowledgeQueryLog 和 JobTask 看似两个独立系统,但它们的协作模式才是可观测性的最后一公里:当 AI Agent 检索失败(KnowledgeQueryLog.evalScore < 3),它可能会触发 JobTask 重跑某条解析任务——这条因果链必须能从两边拼出来。
实现方式是 KnowledgeQueryLog.evalReason 字段预留为「MiniMax 自然语言评估理由」,未来如果发现某类查询系统性失败,可以 grep evalReason 反推哪些 JobTask 需要重跑:
-- 反向定位:MiniMax 评 1 分的查询 → 触发它的账单/计划
SELECT kql.query, kql.eval_reason, jt.type, jt.bill_id
FROM knowledge_query_logs kql
JOIN job_tasks jt ON jt.id = ANY(ARRAY['${jobTaskId-from-context}'])
WHERE kql.eval_score <= 2
  AND kql.created_at BETWEEN '2026-08-01' AND '2026-09-01'
ORDER BY kql.created_at DESC;
这种「双日志交叉验证」是 AI 工程可观测性区别于传统软件可观测性的关键差异——传统系统只观测「我做了什么」,AI 系统还要观测「我做得对不对」。
五、4 条可观测性纪律:把日志写得像工单
把上面 3 类 Logger + KnowledgeQueryLog + JobTask 状态机合在一起看,可以提炼出 4 条贯穿始终的纪律:
纪律 1 · 命名空间是契约,不是装饰
NestJS Logger("Bootstrap") 的第一参数必须和类名 / 文件名 / 业务域对齐:
- 类名:
new Logger(ParseWorker.name)← 类名变 → Logger name 同步变 - 文件名:
const logger = new Logger("SkillLoader")← 移到agents/skill-loader.ts→ Logger name 不变 - 业务域:
new Logger("Bootstrap")← 启动钩子专用
纪律是:SRE 在 Kibana 上 grep \[Bootstrap\] 能立刻定位到 API 启动期所有日志,不需要去翻代码。命名空间一旦定了就不许改——改了等于「撕毁契约」。
纪律 2 · 日志带 ID,不带全文
Job ${job?.id} failed 带的是 BullMQ 的 job.id,不是把整条 Job 数据 JSON.stringify 出来:
// ❌ 错误:日志里塞全文
this.logger.error(`Job ${JSON.stringify(job?.data)} failed: ${err.message}`);

// ✅ 正确:日志里只有 ID + 摘要
this.logger.error(`Job ${job?.id} failed: ${err?.message}`, err?.stack);
全文留在 JobTask.errorMessage 字段里,通过 jobTaskId 反查数据库——日志是「线索」,数据库才是「证据」。把全文塞日志会让日志文件膨胀到 GB 级别,grep 性能断崖式下降。
纪律 3 · 失败兜底必须可回放
JobTask ${jobTaskId} failed 回写失败 这条日志看起来不起眼,但它揭示了一个关键设计:
任何「写日志 + 写数据库」的双写逻辑,必须有「写日志失败时的兜底日志」——否则日志和数据库会脱钩,SRE 看到日志说「成功了」但数据库里其实没写。
onJobFailed 的结构是:
外层 try (数据库写)
  └ 成功 → logger.warn(`已由 failed 兜底置为 FAILED`)
  └ 失败 → logger.error(`failed 回写失败`, e)
双层 try + 双层日志,任何一层断了都能在另一层找到证据——这就是「日志可回放」的真正含义。
纪律 4 · 观测系统不能反推业务系统
scheduleBackgroundWork 里的 void this.repository.logQuery(...).catch(...) 是个不起眼但关键的设计:
void让logQuery不被 await,RAG 检索本身不会因为观测落库慢而变慢.catch把观测落库失败降级为logger.warn,而不是 throw
观测系统永远是「主动观测,被动降级」——即使观测挂了,业务系统必须继续工作。这条纪律适用于所有 fire-and-forget 模式:EmbedderInitializer 循环失败时只是 logger.warn;KnowledgeQueryLog 写入失败时也是 logger.warn;JobTask 兜底失败时是 logger.error 但不 throw——因为 throw 会让进程崩溃,进而影响业务系统。
六、写在最后:可观测性是 SRE 的「最后一公里」
把可观测性做好不是技术问题,是「对不在场同事的善意」——凌晨 3 点那个不在场的同事,拿着 grep 关键词翻日志,希望能在 25 分钟内定位到「京东 POP / 2026-08-05 / 第 873 行」,而不是被 47 万条同名 parse failed 困住 25 分钟还没拼出全貌。
轻易云智能对账系统这套可观测性体系,核心不是 6 个具名 Logger,也不是 KnowledgeQueryLog + JobTask 两张观测表,而是「每一行日志都自带定位坐标」的工程纪律——Bootstrap / SkillLoader / EmbedderInitializer / KnowledgeService / ParseWorker / LlmEvaluator 这 6 个命名空间,对账系统的金蝶云星空集成场景里同样适用:每条 Kingdee 推送失败、每个对账计划取消、每条转换单据生成,都能 grep 出一个「带业务上下文的工单」。
把日志写得像工单,不只是为了 SRE——也是为了让自己 6 个月后回来翻日志时,能在 5 分钟内拼出「那条诡异的解析失败到底发生了什么」。可观测性的最高境界,是日志即文档——你的代码活成什么样,你的日志就活成什么样。